
L'application
openplate enregistre les aliments et, si tu le souhaites, estime les macronutriments à partir d'une photo d'assiette. Cherche un aliment ou scanne une assiette, et l'entrée s'ajoute à ton journal du jour. Sur ta propre installation, aucun écran d'inscription : ouvre l'application et commence à consigner. Sur l'instance hébergée, tu te connectes d'abord.
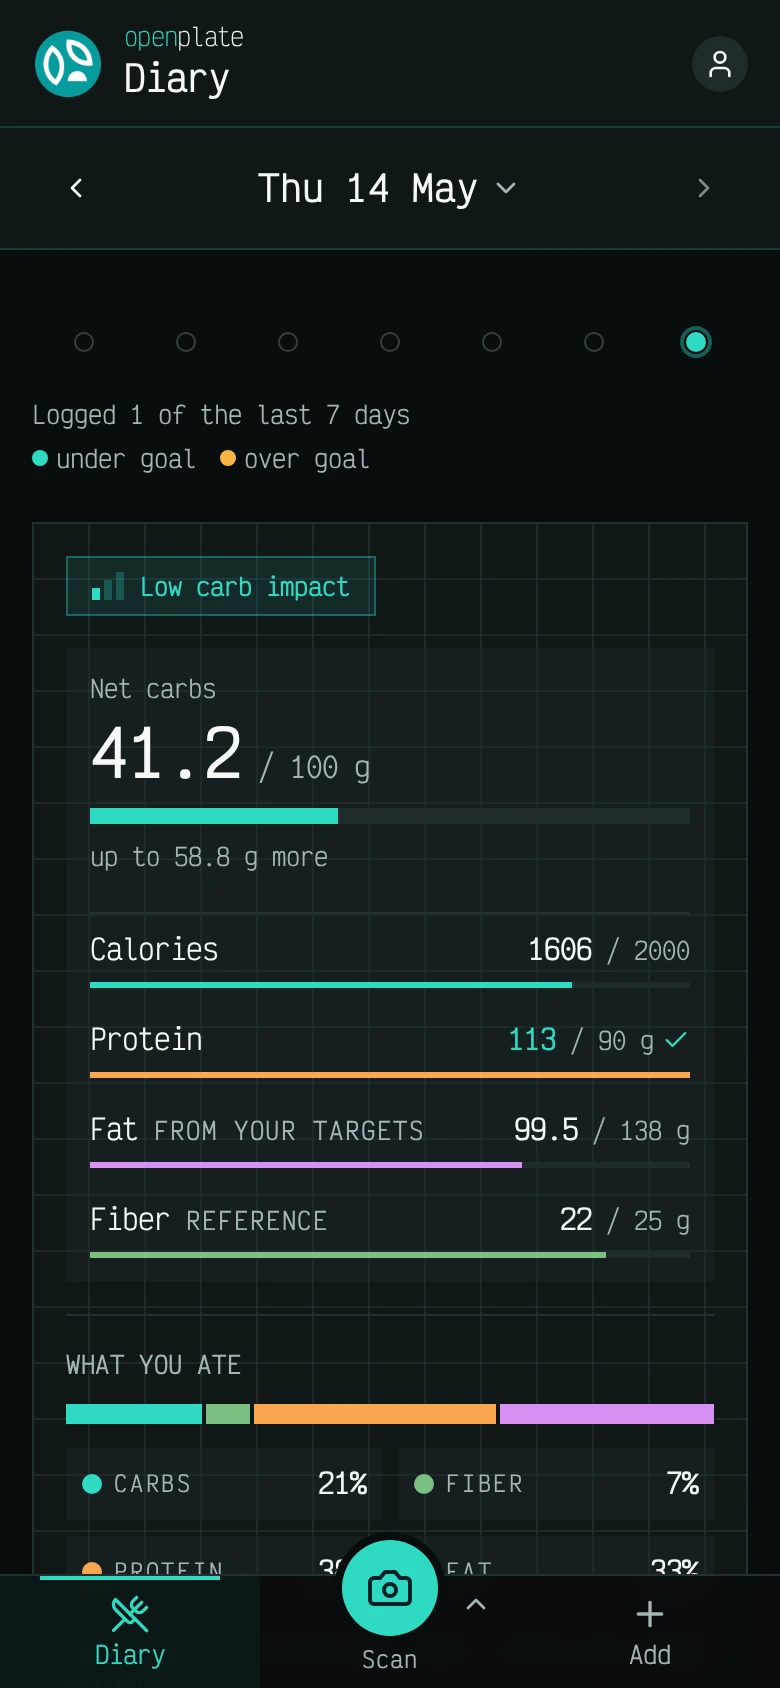
Le journal fonctionne jour par jour : les repas enregistrés, ce qu'ils consomment sur la limite du jour, et ce qu'il en reste.
Ces écrans affichent des données d'exemple, pas un vrai journal.
Aucun magasin d'applications intermédiaire
openplate est une application web (une PWA) que tu installes depuis le navigateur, sur un téléphone ou un ordinateur. Il n'y a pas de magasin d'applications. Personne n'a besoin d'un compte Apple ou Google, et aucune validation ni commission de boutique ne s'interpose entre une version et ton appareil. Une institution qui héberge openplate la distribue depuis son propre domaine, et chaque mise à jour est appliquée sur chaque appareil à la prochaine ouverture de l'application.
Les rappels sont facultatifs. Si tu les actives, ils transitent par le service de notifications push de l'éditeur de ton navigateur, comme pour toute notification web.
Ce qui est stocké sur l'appareil
Tout ce qu'un utilisateur possède (repas enregistrés, pesées, aliments personnels, objectifs, réglages de l'IA) est écrit dans l'IndexedDB du navigateur sur l'appareil où la saisie a eu lieu (app/lib/local-store/). Les données y sont stockées en clair, car c'est ton appareil, et elles n'en sortent jamais sauf sous deux formes que tu choisis : un export JSON que tu télécharges, ou un blob de synchronisation chiffré.
Le serveur applicatif est un simple conteneur sans état. Ni base de données, ni ORM, ni migrations, et aucun secret nécessaire pour démarrer. Il peut conserver exactement un secret optionnel, la clé de la base de données d'aliments de l'administrateur, décrite ci-dessous. Détruire le conteneur ne détruit rien. Ce n'est pas de la frugalité, c'est tout l'engagement du projet : voir ADR-0006.
Ce qui quitte l'appareil
Une photo d'assiette est lue dans le navigateur et envoyée directement au point de terminaison compatible OpenAI que tu as configuré. Le serveur openplate n'intervient jamais dans cette requête. Elle n'est pas téléversée ici, pas écrite sur le disque, pas consignée dans les journaux. Seuls les chiffres résultants sont enregistrés, dans le stockage local de l'appareil ; la photo reste sur l'appareil qui l'a prise, exclue des exports JSON comme des charges utiles de synchronisation.
Ce point de terminaison est soit un fournisseur cloud que tu paies (la voie BYOK), soit ton propre conteneur openplate-inference. Dans le cas auto-hébergé, le modèle nomme les aliments dans l'assiette et estime les grammes, puis le macronutriments sont recherchés, pas inventés : les glucides, les protéines, les lipides et les kcal sont résolus par nom par rapport à la source d'aliments configurée, par défaut un extrait intégré de USDA FoodData Central (8 041 aliments génériques livrés dans l'image, aucun appel réseau, domaine public). Le modèle de langage ne génère jamais le moindre chiffre de macro.
Comme le navigateur effectue cet appel, le point de terminaison doit être une adresse qu'un navigateur peut joindre. Un nom d'hôte compose comme http://inference:8300/v1 ne fonctionnera pas, même si les deux conteneurs peuvent communiquer ainsi entre eux. Utilise l'adresse LAN de l'hôte, un nom tailnet, ou un nom d'hôte sur ton proxy inverse.
Documentation: architecture, auto-hébergement